Day 6|一条 SQL 的完整生命周期:从连接、解析、绑定、优化、调度到结果返回
前五天,我们已经完成了 Doris 的定位、架构总览、架构形态与版本选择,并搭出了第一个可查询的实验集群。今天沿着一条 SQL 的完整旅程,观察数据库内部怎样把一段 SQL 文本转化为分布式执行任务。
这项知识直接决定慢查询诊断的上限。很多团队看到查询耗时升高,第一反应是增加 BE、调整并行度或提高内存。实际耗时可能产生在 FE 规划阶段,也可能产生在 BE 执行阶段,还可能来自连接等待、外部元数据访问、结果编码和客户端消费。只有先标出完整链路,后续参数调整才有清晰依据。
本日的学习地图可以先用一条主链记住:
接入 :客户端经 MySQL 协议连接 FE,确定 Session、权限与资源上下文;规划 :Parser 生成 AST,Binder/Analyzer 完成绑定与语义检查,Nereids 经 RBO、CBO 产出物理计划;调度 :物理计划按 Exchange 边界切成 PlanFragment DAG,Coordinator 把 Fragment Instance 下发到 BE;执行 :BE 以 PipelineTask 运行 Scan、Join、聚合等向量化算子,Exchange 在节点间交换数据;返回 :Root Fragment 汇总结果,经协议编码返回客户端;证据 :EXPLAIN 看计划、Query Profile 看执行,Query ID 串联日志与审计。
Day 6 聚焦四个核心结果:
能从客户端连接开始,完整说明 SQL 在 FE 中经历的解析、绑定、优化与调度过程;
能区分 SQL 文本、Token、AST、绑定逻辑计划、物理计划、PlanFragment 和 Fragment Instance;
能解释 Coordinator 如何把抽象计划落实到具体 BE 节点;
能用 EXPLAIN、Query Profile、Processlist、审计日志和 Query ID 建立一条可复现的证据链。
今天会触及执行引擎,但不会展开 Pipeline 调度和 Spill 的全部细节。RBO、CBO、统计信息和 Runtime Filter 的优化器原理,以及 Fragment、Exchange、Pipeline、向量化和 Spill 的执行细节,会在后续章节分别展开。
一、先建立两只时钟:规划时间与执行时间
一条 SQL 的用户感知耗时可以拆成多个部分:
用户感知耗时
= 连接与排队
+ FE 解析、绑定和优化
+ Fragment 调度
+ BE 扫描与计算
+ 网络 Exchange
+ 结果汇聚与协议编码
+ 客户端拉取和渲染
工程上最先要区分两只时钟。
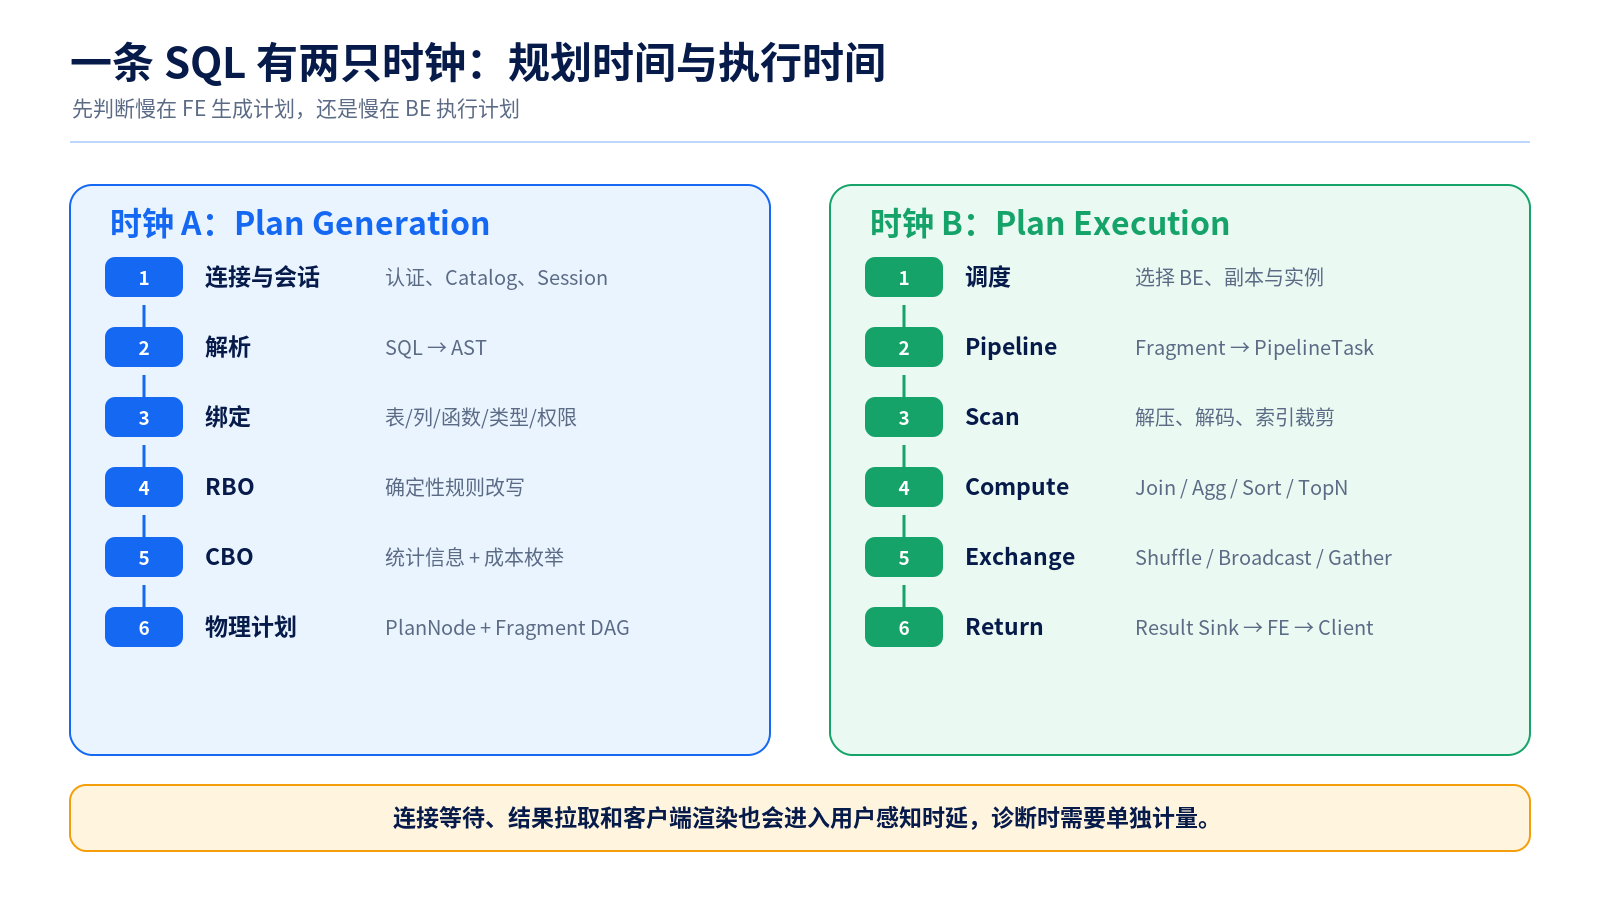
时钟 A:Plan Generation。 它覆盖连接上下文确认、SQL 解析、对象绑定、权限检查、规则改写、代价优化、物理计划生成和 Fragment 切分,主要消耗 FE 的 CPU、内存和元数据访问能力。
时钟 B:Plan Execution。 它覆盖 BE 节点调度、PipelineTask 运行、Segment 扫描、Join、聚合、排序、Exchange、Spill 和结果返回,主要消耗 BE 的 CPU、内存、磁盘、网络与远端存储能力。
一条 SQL 的两只时钟
两只时钟的优化方式差异很大。规划阶段过慢时,扩容 BE 通常很难解决问题;执行阶段过慢时,只盯 FE 日志也找不到根因。结果集很大时,SQL 计算已经完成,客户端仍可能持续等待。生产排障应把“总耗时”继续拆到具体阶段。
一个实用的第一轮判断方式如下:
现象
首要怀疑方向
第一组证据
SQL 提交后长时间看不到 BE 开始工作
FE 解析、元数据、优化器搜索空间
FE CPU、审计日志、Plan Time、EXPLAIN
BE 很快开始执行,查询持续很久
扫描、Join、聚合、排序、Exchange
Query Profile、BE 指标
SQL 很快算完,客户端仍在接收
结果集过大、协议编码、网络、客户端消费
ReturnRows、网络带宽、客户端 Fetch 行为
相同 SQL 有时很快、有时很慢
数据倾斜、缓存、统计信息、入口 FE、并发争用
Profile 的 min/avg/max、缓存指标、Session 快照
二、连接进入 FE:查询开始前已经确定了一组上下文
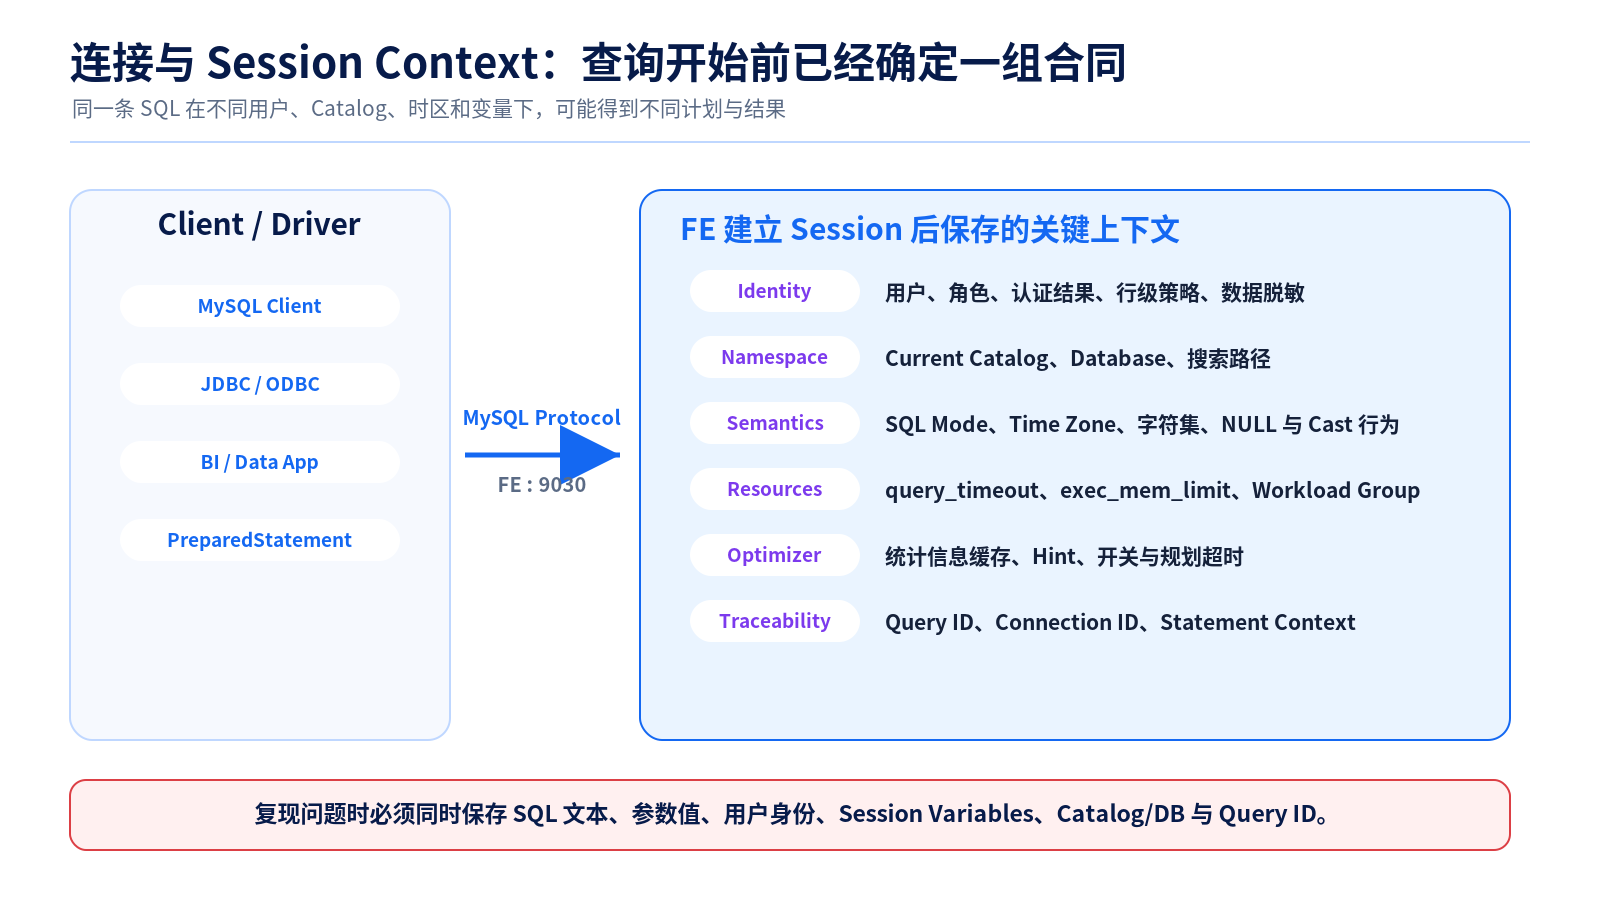
Doris 高度兼容 MySQL 协议。MySQL Client、JDBC、ODBC、BI 工具和应用连接池通常通过 FE 的 MySQL 服务端口建立连接。握手阶段完成协议协商、用户认证和会话创建。连接建立后,FE 会维护一组 Session Context,它们参与后续解析、权限、优化和资源控制。
连接与 Session Context
2.1 身份上下文
身份上下文包含用户、角色、认证结果、来源地址,以及可能生效的行级策略、列权限和数据脱敏规则。相同 SQL 由不同用户执行,最终可见数据和缓存签名可能不同。复现权限类问题时,应保存 CURRENT_USER()、登录来源、角色和目标对象权限。
2.2 命名空间上下文
未写完整限定名的表,需要依赖当前 Catalog 和 Database 完成解析。例如:
SELECT * FROM orders;
这条 SQL 在 internal.sales 和 hive.sales 下可能指向完全不同的数据对象。生产脚本和跨系统任务建议使用完整名称:
SELECT * FROM internal.sales.orders;
完整限定名还能减少迁移、灰度和多 Catalog 环境中的歧义。
2.3 语义上下文
时区、SQL Mode、字符集、隐式类型转换和 NULL 行为会影响结果。日期边界、字符串转数值、夏令时和小数精度问题经常来自 Session 差异。性能问题复现时只保存 SQL 文本远远不够,参数值和 Session Variables 也要一起保存。
2.4 资源上下文
query_timeout、查询内存上限、Workload Group、并发限制和 Profile 开关都会进入本次查询的执行合同。某条 SQL 在 DBA 会话中能够成功,在 BI 账号中被限流或超时,常见原因就是资源上下文不同。
2.5 可追踪上下文
连接建立后可以通过 CONNECTION_ID() 获取连接标识。查询进入执行流程后会形成 Query ID。Query ID 是串联 Processlist、Profile、FE Audit Log 和 BE 日志的核心字段。
SELECT CONNECTION_ID();
SHOW PROCESSLIST;
SHOW VARIABLES LIKE 'query_timeout';
SHOW VARIABLES LIKE 'enable_profile';
在多 FE 集群中还要记录实际入口 FE。当前 Query Profile 保存在执行 SQL 的 FE,多个 FE 之间不会自动同步 Profile。通过负载均衡访问集群时,排障人员需要回到原入口 FE 获取完整 Profile。
2.6 Arrow Flight SQL 的位置
Doris 4.x 仍以 MySQL 协议作为通用接入主路径。Arrow Flight SQL 提供列式结果传输,适合大批量结果读取和 Arrow/Pandas 等列式客户端。目前官方将这项能力标记为实验功能,生产主链路应先完成兼容性、稳定性和故障恢复验证。
2.7 不同查询会走不同长度的路径
上面的生命周期描述的是通用查询主路径。Doris 还提供若干加速路径,它们会复用或跳过部分阶段。理解这些路径,可以避免看到“同一条 SQL 第二次特别快”时误判数据库已经自动优化了所有工作。
Prepared Statement。 首次 PREPARE 或 JDBC 服务端预编译仍需完成解析、绑定和计划准备。后续执行只替换参数,并复用 Statement Context。高频重复 SQL 可以明显降低 FE 解析和规划 CPU。参数类型、Schema 版本或会话环境发生变化时,系统仍可能重新准备上下文。
SQL Cache。 当 SQL 文本、视图定义、表或分区版本、用户变量和行策略等签名一致时,结果可以从缓存直接返回。此时 BE 扫描与计算可能完全消失。缓存适合低频更新和高频重复查询,实时写入频繁的分区命中率通常较低。
Short-Circuit Point Query。 满足 Unique Key MoW、完整主键等值条件和相关表属性时,FE 可以生成短路点查路径,减少通用 OLAP 计划中的 Fragment 与算子开销。它仍然受到身份、Session、Tablet 定位和 BE 可用性的约束。
物化视图改写。 用户提交的 SQL 保持不变,Nereids 在逻辑优化阶段把查询改写到同步或异步物化视图。Explain 看到的 Scan 对象可能已经从明细基表变成预聚合结果表。
DDL、DML 和 LOAD。 这些语句也经过协议接入、解析、权限和语义检查,后续会进入元数据变更、事务、导入或 Job 调度链路。本文的 Fragment 和 Result Sink 主要描述 SELECT 查询。
排障时要先确认本次查询走了哪条路径。缓存命中、Prepared Statement、短路点查和 MV 改写都会改变耗时结构,冷启动与热路径应分开测试。
三、Parser:把字符流组织成语法结构
客户端发送给 FE 的最初内容只是一段字符串。Parser 需要确认字符串符合 SQL 语法,并构造后续阶段能够处理的树形结构。
SQL 文本到 AST
解析可以分为两个概念步骤。
3.1 词法分析:识别 Token
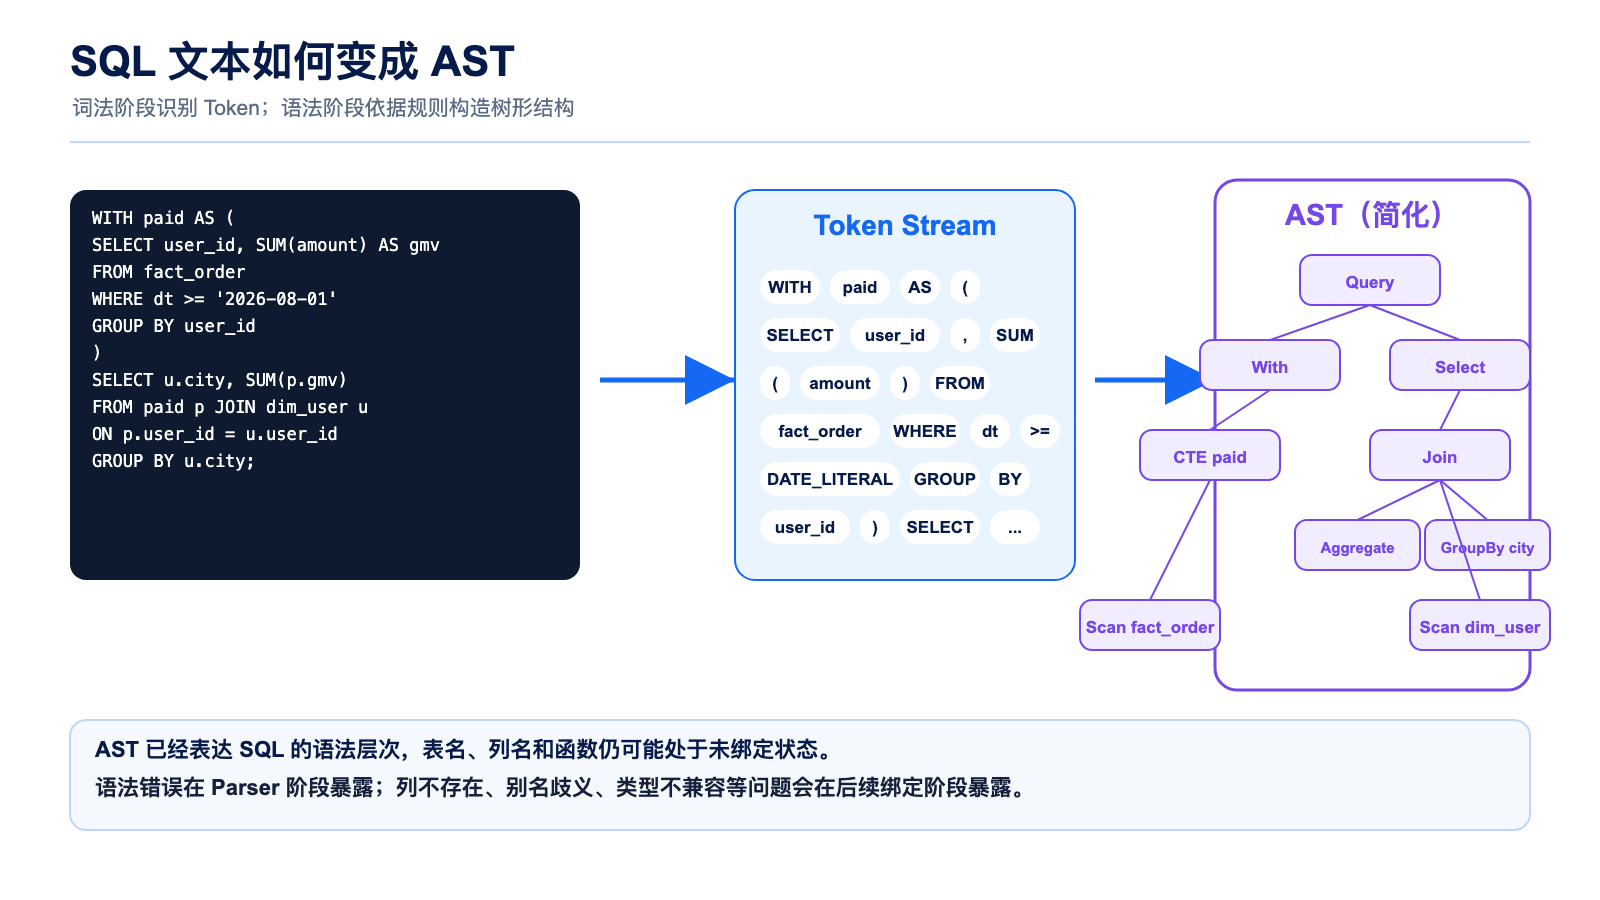
词法阶段会把字符流切分成关键字、标识符、运算符、字面量和标点。例如:
SELECT user_id, SUM(amount)
FROM fact_order
WHERE dt >= '2026-08-01'
GROUP BY user_id;
可以被识别为:
SELECT | IDENTIFIER(user_id) | , | FUNCTION(sum) | (
IDENTIFIER(amount) | ) | FROM | IDENTIFIER(fact_order)
WHERE | IDENTIFIER(dt) | >= | DATE_LITERAL | GROUP | BY | ...
词法错误通常来自未闭合字符串、非法字符和错误的转义。解析阶段尚未确认 fact_order 是否存在,也不知道 amount 的真实类型。
3.2 语法分析:构造 AST
语法阶段按照 SQL Grammar 组织 Token,形成抽象语法树 AST。AST 会表达 SELECT 列表、FROM、JOIN、WHERE、GROUP BY、ORDER BY、LIMIT、CTE 和子查询之间的结构关系。
AST 解决“这段 SQL 怎样组织”的问题,仍然保留大量未解析对象。例如 user_id 可能来自多张表,sum 需要匹配具体重载,orders 需要结合 Catalog 与 Database 定位。
早期实现曾使用 JFlex 与 Java CUP 做词法和语法分析,这对建立概念很有帮助。当前 4.x 课程将 Nereids 的语法与逻辑计划构建链路作为主入口,不把具体生成器和类名当作长期稳定接口。内核实现会演进,Token、AST、绑定计划和物理计划之间的层次关系更适合作为长期知识。
3.3 Parser 能发现什么
Parser 可以发现:
关键字顺序错误;
括号不匹配;
字符串未闭合;
JOIN、CASE、WITH 等结构不完整;
当前语法版本不支持的写法。
Parser 无法独立发现:
表或列不存在;
列名歧义;
用户缺少权限;
函数参数类型不匹配;
聚合语义错误;
Join 顺序代价过高。
因此,“SQL 语法正确”只说明它通过了第一层门禁。
四、Binder 与 Analyzer:让 AST 绑定到真实数据世界
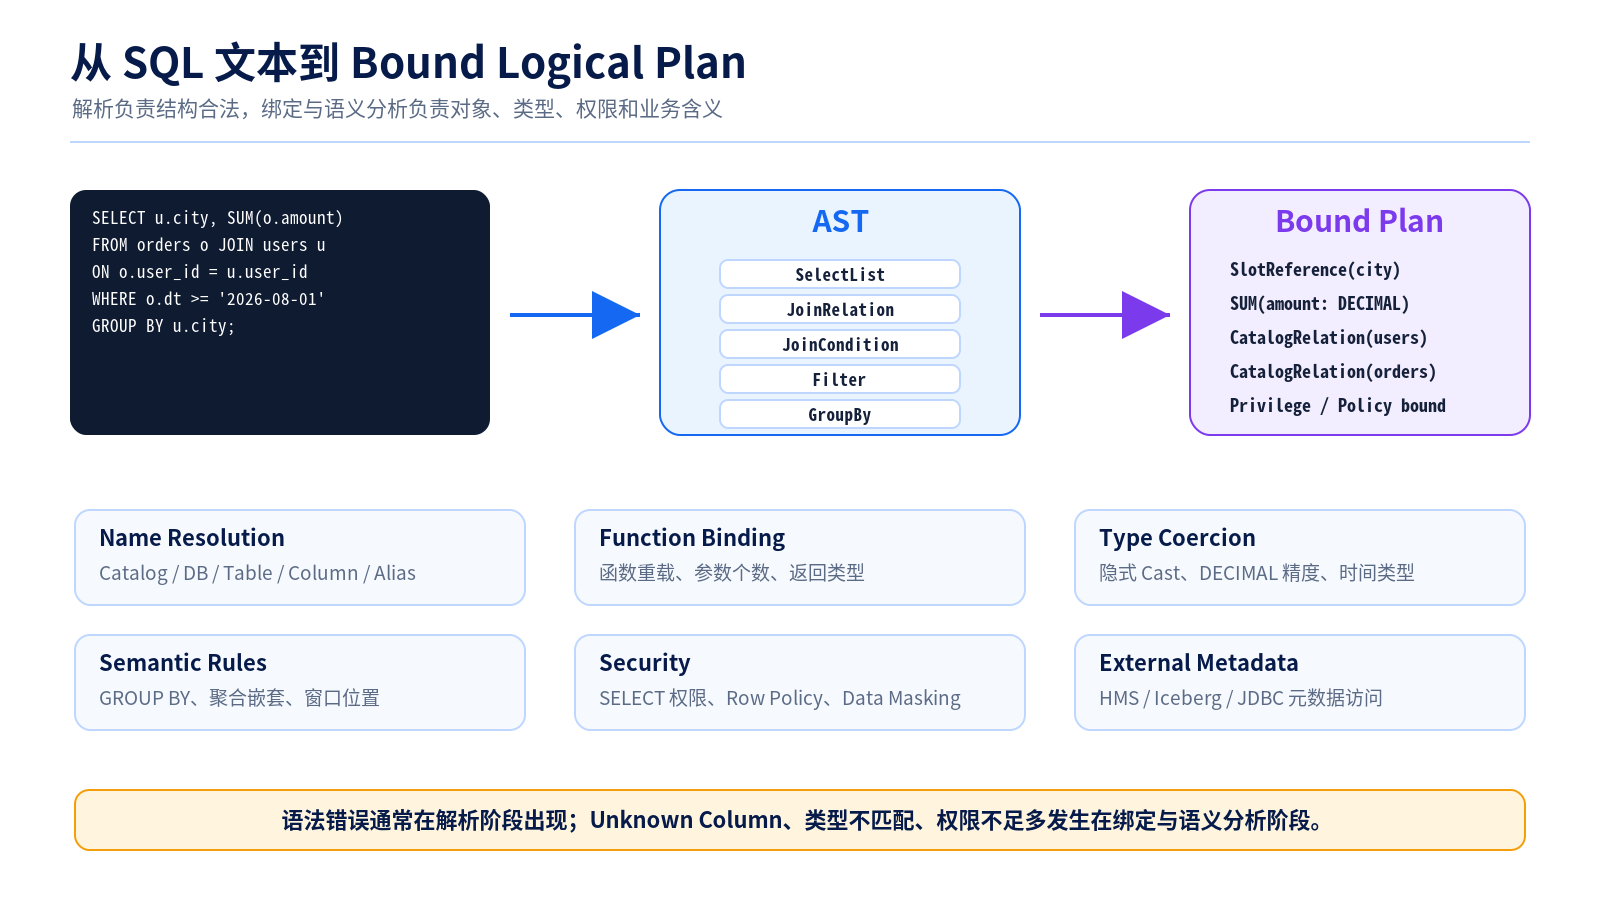
绑定与语义分析负责把 AST 中的名字、类型和规则落实到当前 Session、Catalog 和 Schema。完成这个阶段后,SQL 才具备明确业务含义。
从 SQL 到 Bound Logical Plan
4.1 名称解析
名称解析通常按照以下路径工作:
Catalog → Database → Table / View → Alias → Column
下面的 SQL 存在歧义:
SELECT user_id
FROM fact_order o
JOIN dim_user u ON o.user_id = u.user_id;
两张表都有 user_id。生产 SQL 应明确写成 o.user_id 或 u.user_id。明确别名可以降低理解成本,也能减少 Schema 变化后出现意外歧义。
4.2 函数绑定与类型推导
同一个函数名可能存在多种参数签名。Analyzer 需要根据参数类型选择函数实现,并插入必要的类型转换。金额、日期、字符串与 NULL 的隐式转换尤其需要谨慎。
例如:
WHERE order_date = '2026-08-01'
系统会结合 order_date 类型解析字面量。复杂表达式中的 DECIMAL 精度、DATETIME 精度和字符串转换可能影响正确性,也可能让谓词无法下推到存储层。核心过滤条件建议使用显式、同类型的常量。
4.3 语义检查
语义分析会检查:
SELECT 列与 GROUP BY 的关系;
聚合函数嵌套是否合法;
窗口函数所在位置是否合法;
JOIN 条件和子查询结构是否合法;
INSERT 目标列与源列数量、类型是否匹配;
表函数、复杂类型和表达式的参数是否合法。
这解释了一个常见现象:SQL 可以成功生成 AST,随后仍然报 Unknown column、Ambiguous column、类型不匹配或聚合语义错误。
4.4 权限与数据策略
当前用户对 Catalog、Database、Table 和列的权限会在这条链路中被校验。行级策略与脱敏规则还可能向逻辑计划注入过滤或表达式。查询计划因此与身份上下文相关,生产验收要使用真实业务账号执行。
4.5 外部 Catalog 元数据
查询 Hive、Iceberg、Paimon、JDBC 等外部对象时,绑定阶段需要获取外部 Schema、分区和文件等元数据。元数据服务延迟、分区数量过大和海量小文件都可能提高规划成本。此类问题表面上表现为“SQL 还没开始跑”,根因却位于元数据获取和 Split 枚举。
4.6 从未绑定结构到逻辑计划
完成绑定后,计划中的对象会从未解析节点转化为明确关系和表达式:
UnboundRelation("fact_order")
        ↓
LogicalOlapScan(internal.doris_day06.fact_order)
UnboundSlot("u.city")
        ↓
SlotReference(dim_user.city, STRING)
这一步产出的逻辑计划已经说明“要计算什么”,仍未决定 Hash Join 还是 Nested Loop、Broadcast 还是 Shuffle、每个 Fragment 放到哪些 BE。
五、逻辑计划:用关系算子表达计算目标
逻辑计划通常由一组关系算子构成:
LogicalResultSink
└── LogicalLimit
    └── LogicalSort
        └── LogicalAggregate
            └── LogicalJoin
                ├── LogicalFilter
                │   └── LogicalOlapScan(fact_order)
                └── LogicalOlapScan(dim_user)
每个节点描述一种计算语义:Scan 读取关系,Filter 过滤行,Project 计算和裁剪列,Join 关联关系,Aggregate 聚合,Sort 排序,Limit 截断结果。
逻辑计划保持与具体执行算法的距离。LogicalJoin 只表达连接语义和条件,物理层才选择 Hash Join、Nested Loop、Broadcast、Shuffle 或 Colocate。这个区分十分重要:
AST 关注 SQL 语法结构;
Bound Logical Plan 关注业务语义和对象绑定;
Physical Plan 关注具体算法、数据分布和执行成本。
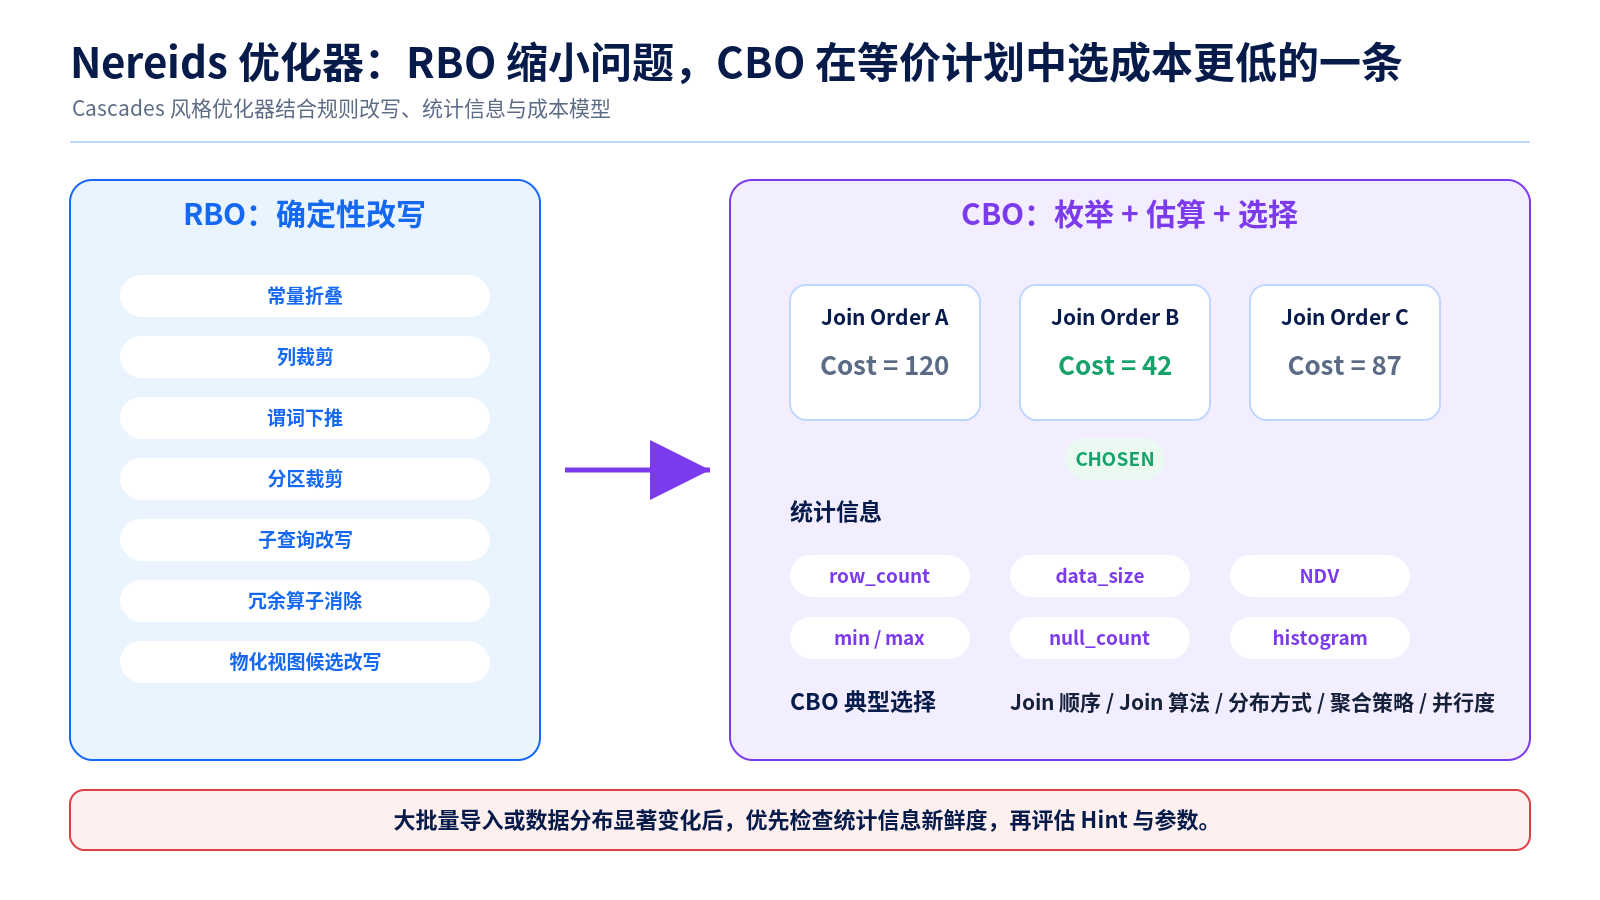
5.1 RBO:确定性规则改写
Nereids 会先用规则改写缩小问题规模。常见规则包括:
常量折叠;
谓词下推;
列裁剪;
分区裁剪;
Limit 下推;
冗余表达式消除;
子查询改写;
物化视图候选改写。
RBO 与 CBO
谓词下推的价值很直观。过滤条件越早执行,后续 Join、聚合和 Exchange 处理的数据越少。下面的写法可能阻碍存储层使用日期范围:
WHERE DATE_FORMAT(order_time, '%Y-%m-%d') = '2026-08-01'
更稳定的写法是:
WHERE order_time >= '2026-08-01 00:00:00'
  AND order_time <  '2026-08-02 00:00:00'
后一种表达直接暴露范围条件,分区裁剪、ZoneMap 和索引更容易参与。
5.2 4.x 的 Nereids 主路径
当前 Doris 4.x 官方架构将 Nereids 作为查询规划主路径,旧 Planner 已退出主教学入口,相关开关也已移除。课程中的所有 Explain、Hint、统计信息和物理计划理解都围绕 Nereids 展开。
六、Memo:在等价表达中控制优化器搜索空间
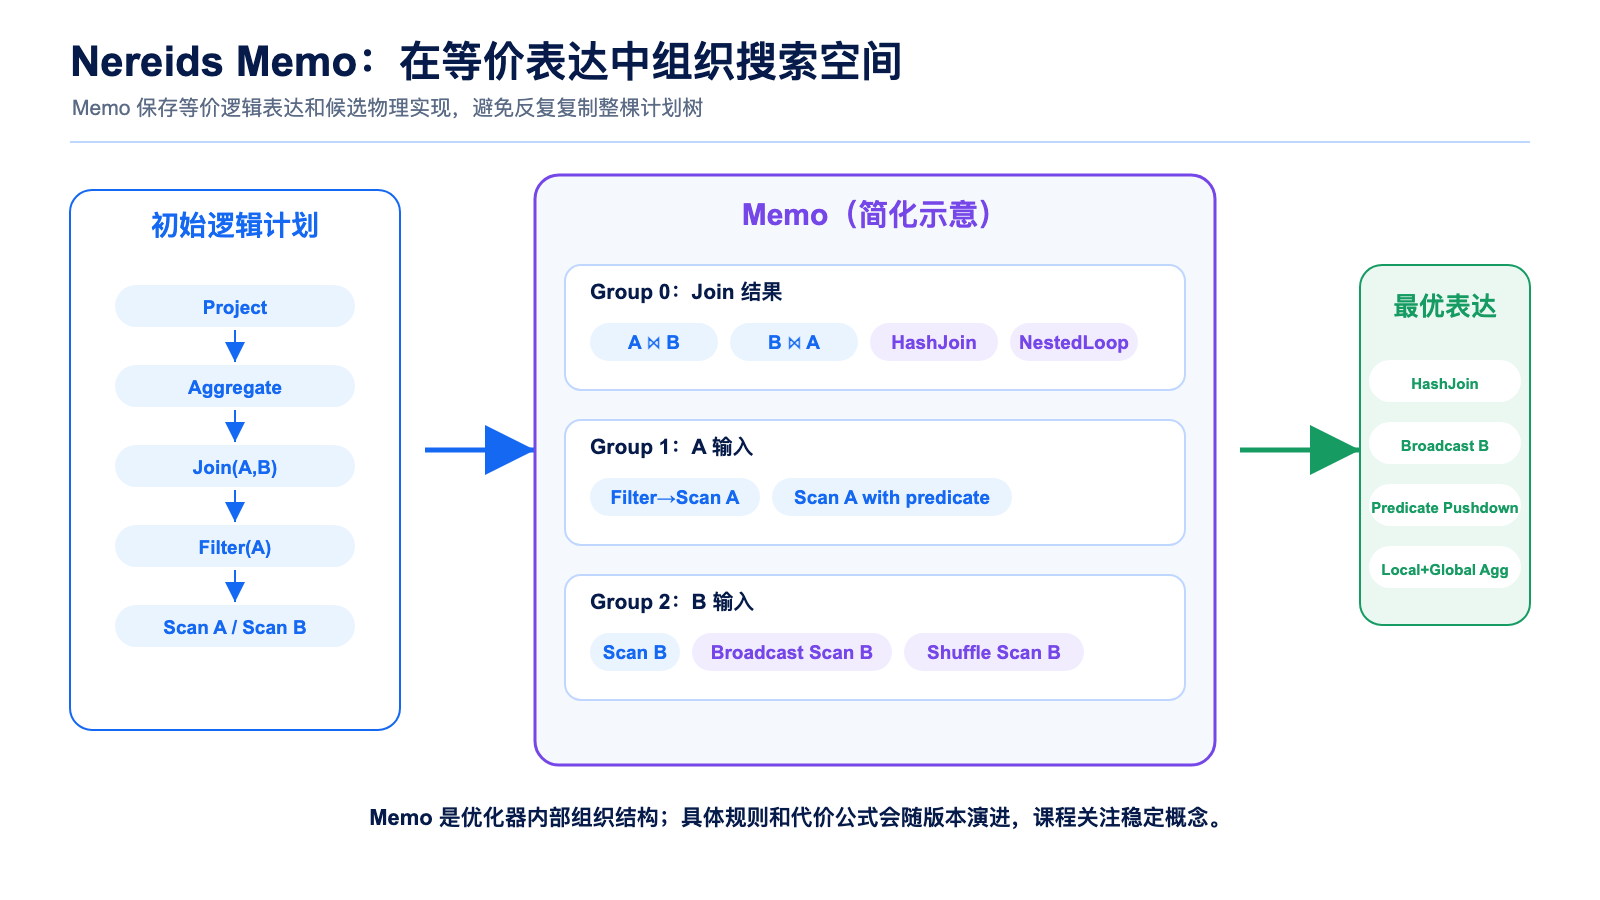
Nereids 采用 Cascades 风格的优化框架。理解 Memo 有助于解释两个问题:同一条 SQL 为什么有多个候选计划,复杂 Join 为什么可能产生较高规划成本。
Nereids Memo 简化图
6.1 等价表达
关系代数中,许多表达在语义上等价。例如内连接在满足条件时可以交换两侧,多个内连接可以调整结合顺序。过滤也可以从 Join 上方下推到某个输入侧。
如果每次改写都复制整棵计划树,搜索空间会迅速膨胀。Memo 将等价表达组织在 Group 中,每个 Group 可以保存多种逻辑表达和物理实现。优化器在 Group 之间复用结果,并记录当前已知的最低代价。
6.2 Memo 中保存什么
简化理解可以分成三类内容:
逻辑等价表达 :不同 Join 顺序、不同过滤位置、不同子查询改写;物理实现候选 :Hash Join、Nested Loop、Broadcast、Shuffle、Local/Global Aggregate;属性与代价 :输出列、数据分布、排序属性、估算行数、CPU、IO、网络和内存代价。
6.3 搜索空间从哪里膨胀
常见来源包括:
Join 表数量增加;
多层视图和 CTE 展开;
多个异步物化视图都可作为改写候选;
复杂子查询和集合运算;
外部 Catalog 中存在大量分区或文件;
统计信息缺失,候选计划难以快速剪枝。
规划时间过长时,先降低搜索空间和元数据规模,效果往往比直接修改 BE 并行度更明确。
Memo 属于优化器内部组织方式,规则集合和代价公式会随版本演进。学习时抓住“等价组、候选实现、属性要求、最低代价”四个稳定概念即可。
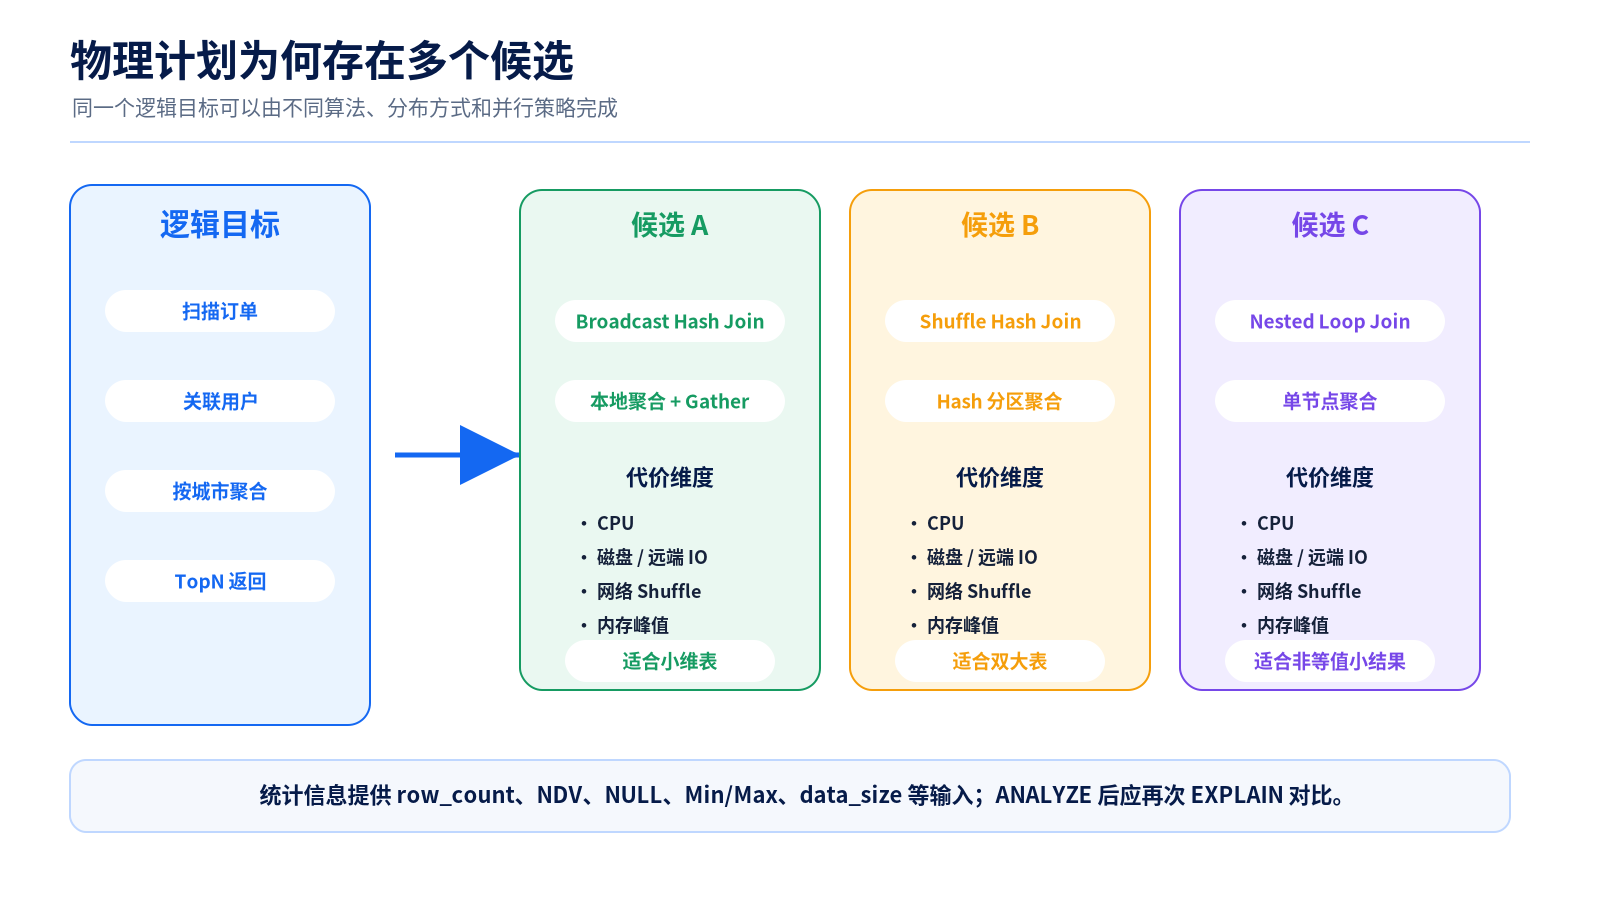
七、物理计划:选择算法、分布和并行方式
逻辑目标确定后,优化器要为每个算子选择物理实现。
物理计划候选
一条 fact_order JOIN dim_user 可能产生多种候选:
Broadcast Hash Join:将小维表发送到相关 BE;
Shuffle Hash Join:两侧按 Join Key 重分布;
Bucket Shuffle:利用一侧已有分桶,只移动另一侧;
Colocate Join:两表预先保持同分桶和同位置;
Nested Loop Join:用于非等值连接或很小输入;
两阶段聚合:BE 本地先聚合,再通过 Exchange 完成全局合并;
TopN:使用排序、运行时范围过滤和分阶段读取等实现。
7.1 CBO 需要哪些统计信息
CBO 会使用表级和列级统计信息估算候选代价。常见统计项包括:
row_count:总行数;data_size:数据量;NDV:不同值数量;null_count:NULL 数量;min / max:值域;平均列宽和分布信息。
ANALYZE TABLE fact_order;
ANALYZE TABLE dim_user;
SHOW ANALYZE;
大批量导入、历史回灌、分区切换和数据分布变化后,统计信息可能滞后。此时优化器可能低估过滤结果、选错 Build Side 或选择代价较高的 Shuffle。处理顺序应当先检查统计信息,再考虑 Hint。
7.2 代价包含什么
代价估算通常综合 CPU、磁盘或远端 IO、网络传输、内存、并行度和属性转换。具体公式属于版本实现细节。工程判断可以用以下问题代替对公式的死记:
会扫描多少分区、Tablet、Segment 和列?
Join 两侧各有多少行和多少字节?
哪一侧建立 Hash Table?
是否需要全量 Shuffle?
聚合前后行数缩减比例是多少?
Sort、Distinct 和窗口函数需要多少状态内存?
数据是否存在热点值和实例倾斜?
7.3 用 Explain 查看选择结果
EXPLAIN SHAPE PLAN
SELECT ...;
适合快速查看 Join 形状、左右顺序和 Distribution。
EXPLAIN VERBOSE
SELECT ...;
适合查看 Scan、Predicates、分区裁剪、Fragment、Exchange 和更详细的物理属性。
Explain 展示优化器准备怎样执行,运行时实际耗时仍需 Profile 验证。
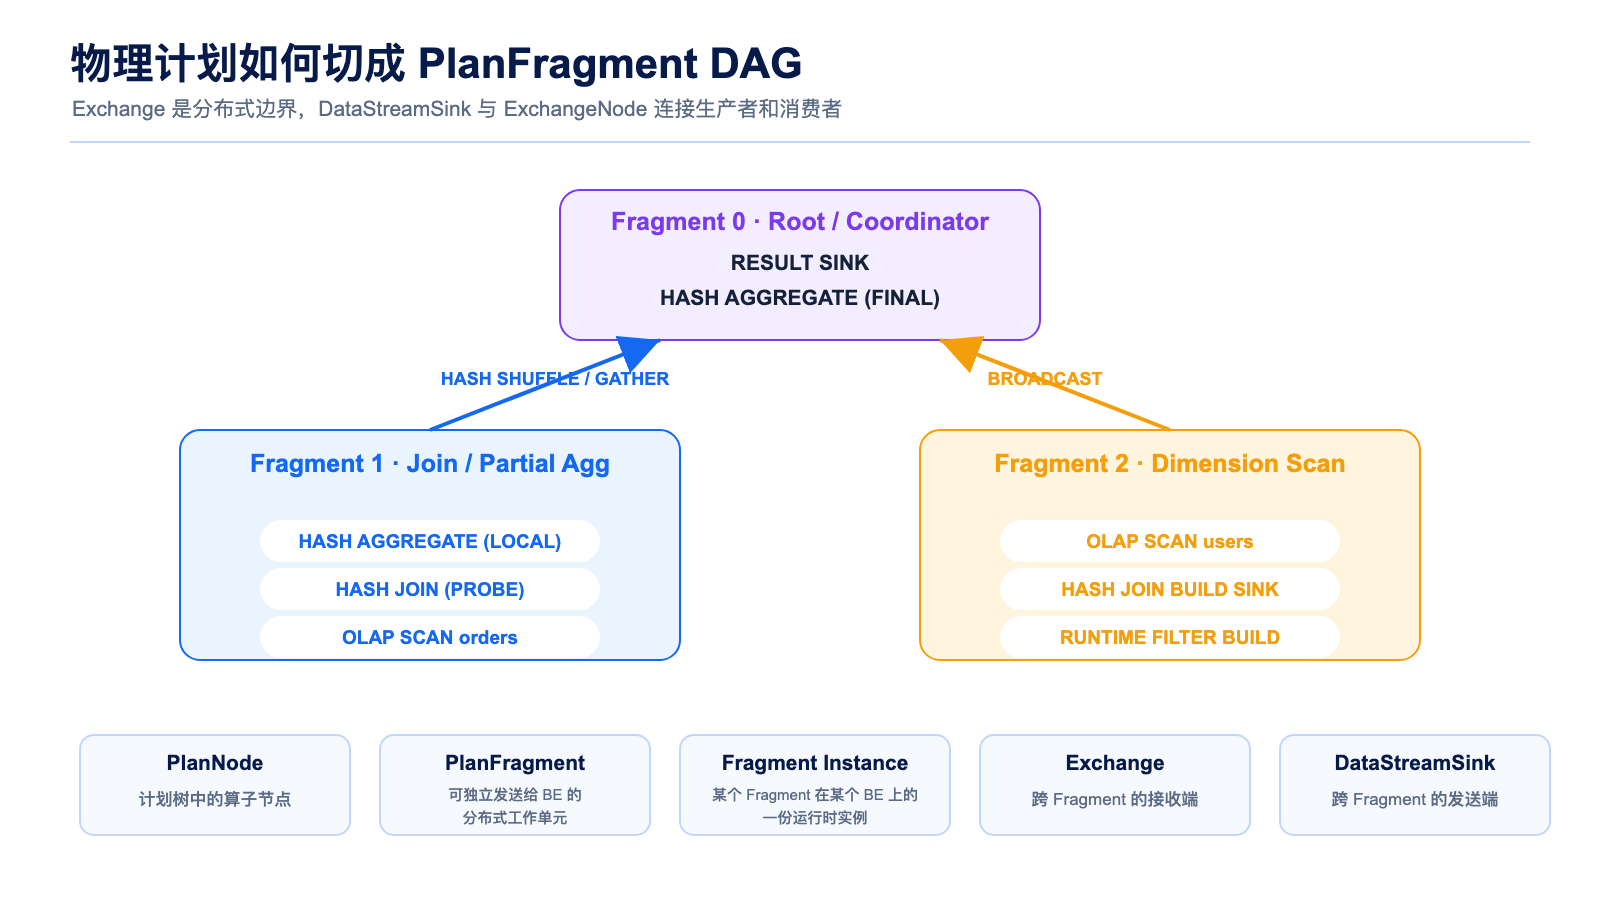
八、从 Physical Plan 到 PlanFragment DAG
物理计划仍然是一棵抽象算子树。分布式执行需要把它切成可以下发到 BE 的工作单元。PlanFragment 是 FE 向 BE 分发的基本单位,一条查询会形成由多个 Fragment 组成的 DAG。
PlanFragment DAG
8.1 为什么要切 Fragment
当上下游算子需要改变数据分布时,会出现 Exchange 边界。例如:
本地聚合结果需要按分组键重新分布,完成全局聚合;
Hash Join 两侧需要按照相同 Join Key 分区;
小表需要 Broadcast 到多个节点;
最终结果需要 Gather 到 Root Fragment;
TopN 需要各节点局部计算后再全局合并。
Exchange 的发送侧通常由 DataStreamSink 承担,接收侧由 ExchangeNode 或对应 Operator 承担。它们共同建立 Fragment 之间的数据通道。
8.2 一个两阶段聚合示例
Fragment 1..N
Scan Tablet
→ Local Aggregate
→ DataStreamSink(Hash Partition by city)

Fragment 0
Exchange
→ Global Aggregate
→ Sort / Limit
→ Result Sink
本地聚合先把每个 BE 上的明细压缩成较小中间结果,可以明显减少网络数据量。分组基数很高时,本地聚合缩减有限,Exchange 压力依然可能很大。
8.3 Fragment 与 PlanNode 的关系
PlanNode 是计划树中的算子节点;PlanFragment 是一组能够在相同数据分布属性下连续执行的 PlanNode。遇到数据重分布边界,计划会切到新的 Fragment。
九、Coordinator:把 Fragment 落到具体 BE
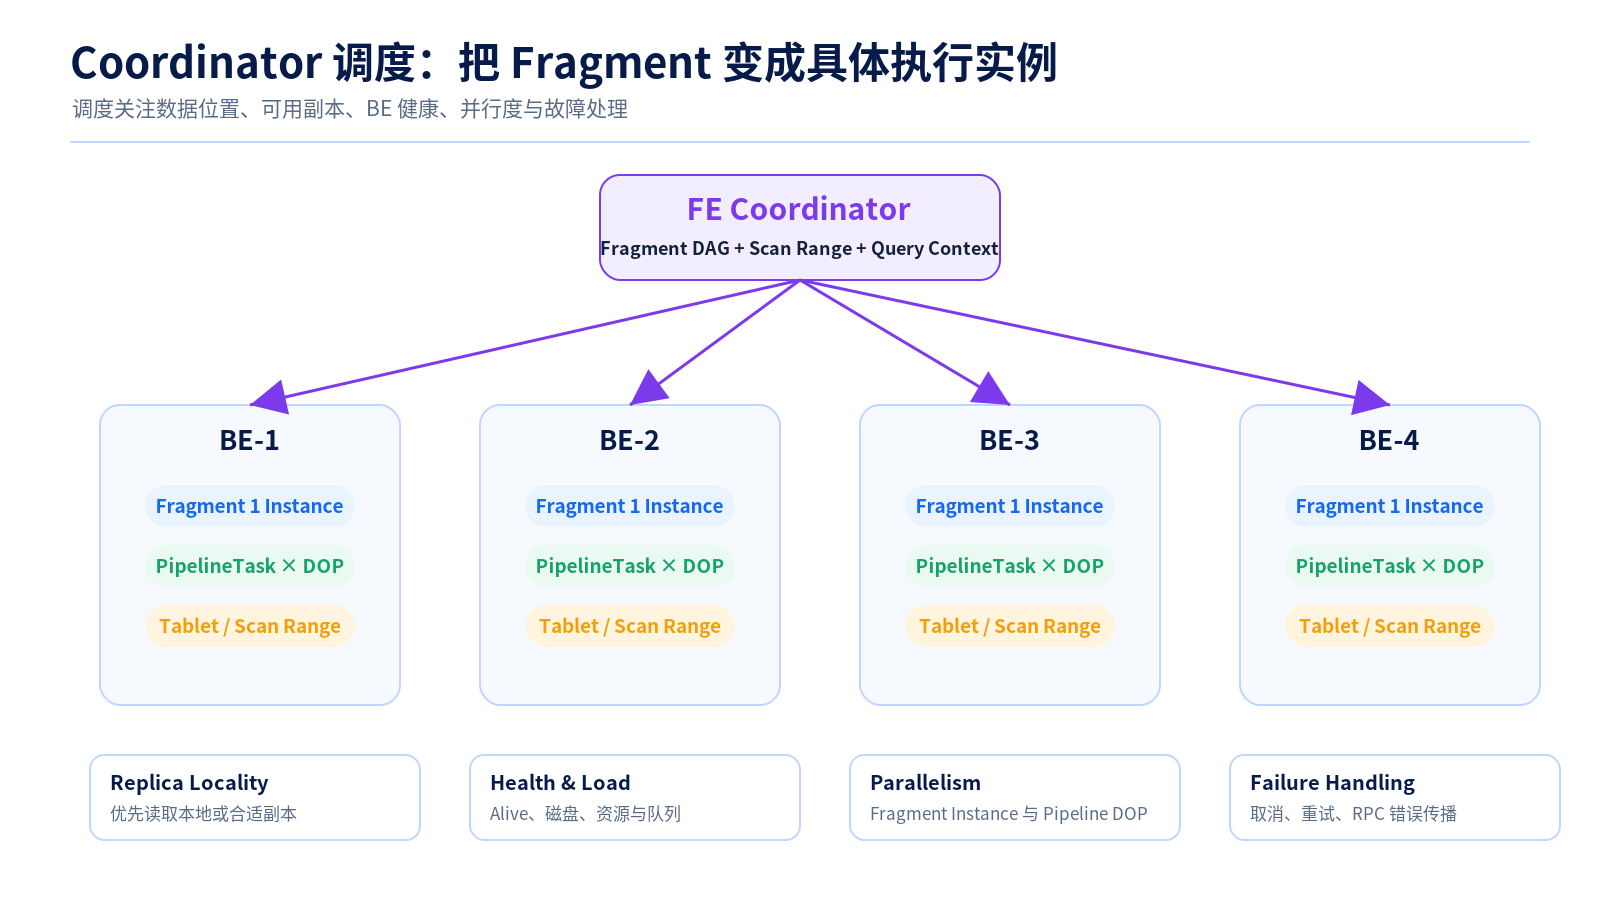
Coordinator 位于 FE 侧。它根据 Fragment DAG、Tablet 副本位置、节点可用性、数据分布、并行配置和资源约束生成执行实例,并把任务下发给对应 BE。
Coordinator 调度
9.1 Fragment Instance
Fragment Instance 是某个 PlanFragment 在具体 BE 上的一份运行副本。多个 Instance 可以并行处理不同 Tablet、不同 Split 或不同数据分区。
需要避免一个常见误解:
Fragment Instance 数量 ≠ 线程数量
BE 收到 Instance 后还会继续拆成 Pipeline 和 PipelineTask。PipelineTask 才会进入执行线程池调度。一个 Instance 可能包含多条 Pipeline,每条 Pipeline 也可能拥有多个 Task。
9.2 节点选择与数据本地性
内部表查询通常优先利用 Tablet 副本位置,让扫描靠近数据。节点故障、副本不可用、磁盘状态和均衡过程都会影响调度选择。外部表查询则依据文件 Split、Compute Group 和缓存位置分发任务。
精确调度策略会随着版本演进。排障时应从 Explain 和 Profile 观察最终 Instance 分布,避免根据单一参数推测。
9.3 Coordinator 的运行期职责
任务下发完成后,Coordinator 还负责:
建立 Fragment 间数据通道;
收集执行状态与错误;
协调 Runtime Filter;
处理超时和取消;
汇聚 Root Fragment 结果;
维护 Query Profile 上下文;
将最终状态写入审计链路。
9.4 调度阶段可能变慢的原因
Tablet 或外部 Split 数量过多;
FE 需要处理海量扫描范围;
部分副本不可用,需要重新选择;
BE 心跳或资源状态异常;
多租户队列等待;
外部 Catalog 文件枚举耗时;
单次 SQL 涉及大量分区和对象。
这类问题通常表现为计划已经生成,BE 真正开始执行前仍有明显等待。
十、BE 执行边界:Instance 怎样进入 Pipeline
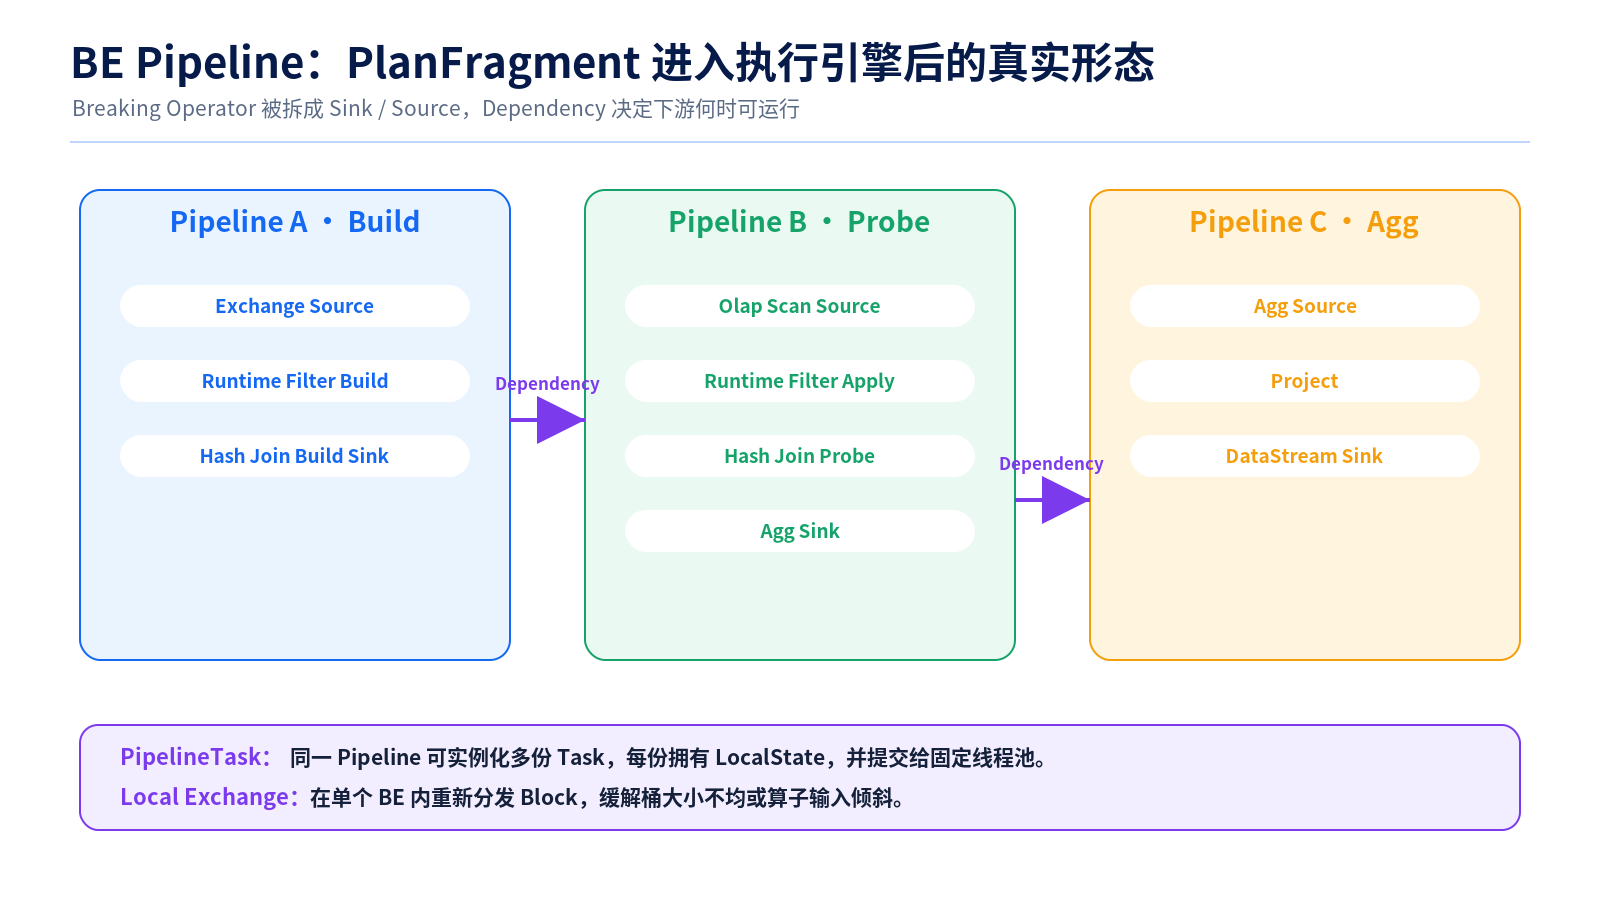
Day 6 只建立边界认知。BE 收到 Fragment Instance 后,会将计划节点转换为 Operator,并按照依赖关系组织成 Pipeline。PipelineTask 进入固定线程池,数据以向量化 Block 形式流动。
Pipeline 依赖关系
常见 Operator 包括:
Scan:读取 Segment 或外部文件;
Filter:执行谓词;
Project:列裁剪与表达式计算;
Hash Join Build / Probe;
Aggregate Local / Global;
Sort / TopN;
Exchange Source / Sink;
Result Sink。
遇到依赖未满足、网络等待或磁盘 IO 时,Task 可以让出线程。阻塞算子会形成 Pipeline 边界。向量化、Pipeline、Operator 依赖和 Spill 的完整原理将在后续章节展开。
10.1 结果返回
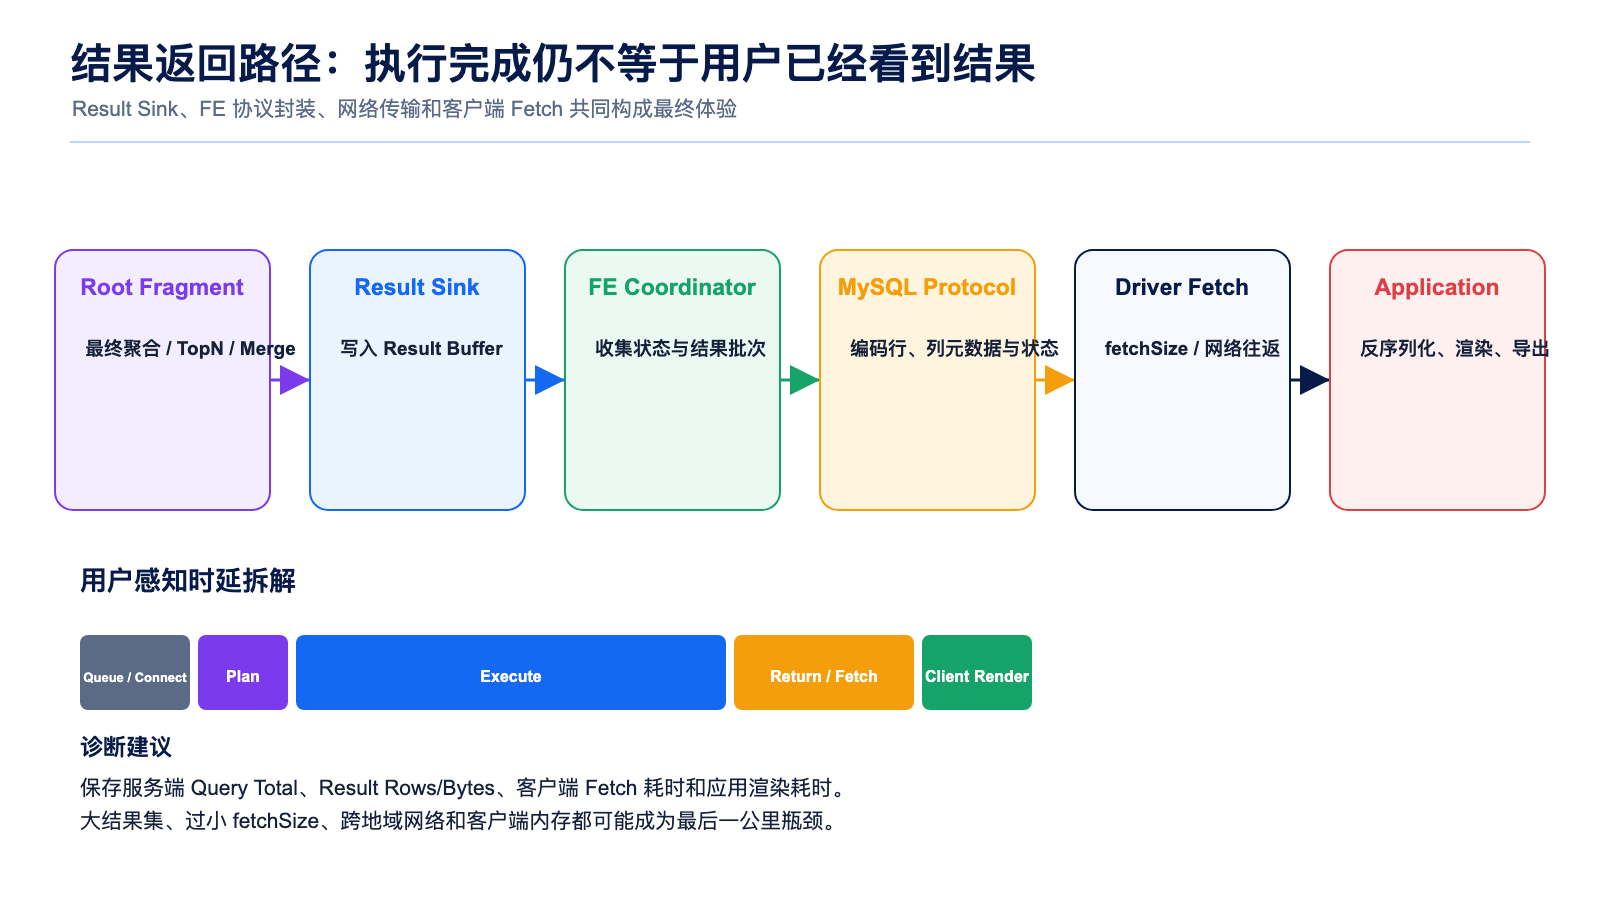
Root Fragment 完成最终聚合、排序和 Limit 后,将结果交给 Result Sink。MySQL 协议路径需要把内部列式 Block 编码成客户端可消费的协议结果。客户端继续通过网络拉取并反序列化。
结果返回与取消
大结果集会带来三类成本:
BE 或 Root Fragment 生成和缓存结果;
FE 执行协议编码和网络发送;
客户端驱动、BI 工具或浏览器消费和渲染。
因此,SELECT * 返回数百万行时,查询算子可能已经很快,用户仍然感到缓慢。在线分析接口应控制列数、行数和分页方式,大规模导出应选择 OUTFILE、Connector 或经过验证的列式读取链路。
10.2 超时和主动取消
SHOW PROCESSLIST;
KILL QUERY <processlist_id>;
-- 也可按 Query ID 终止,具体值从 Processlist 获取
取消信号会由 Coordinator 传播到相关 BE,停止 PipelineTask,并释放内存、扫描和网络资源。用户主动断开连接、query_timeout 到期、节点错误和资源熔断都可能触发查询终止。
十一、Query Profile:把运行时事实收集回来
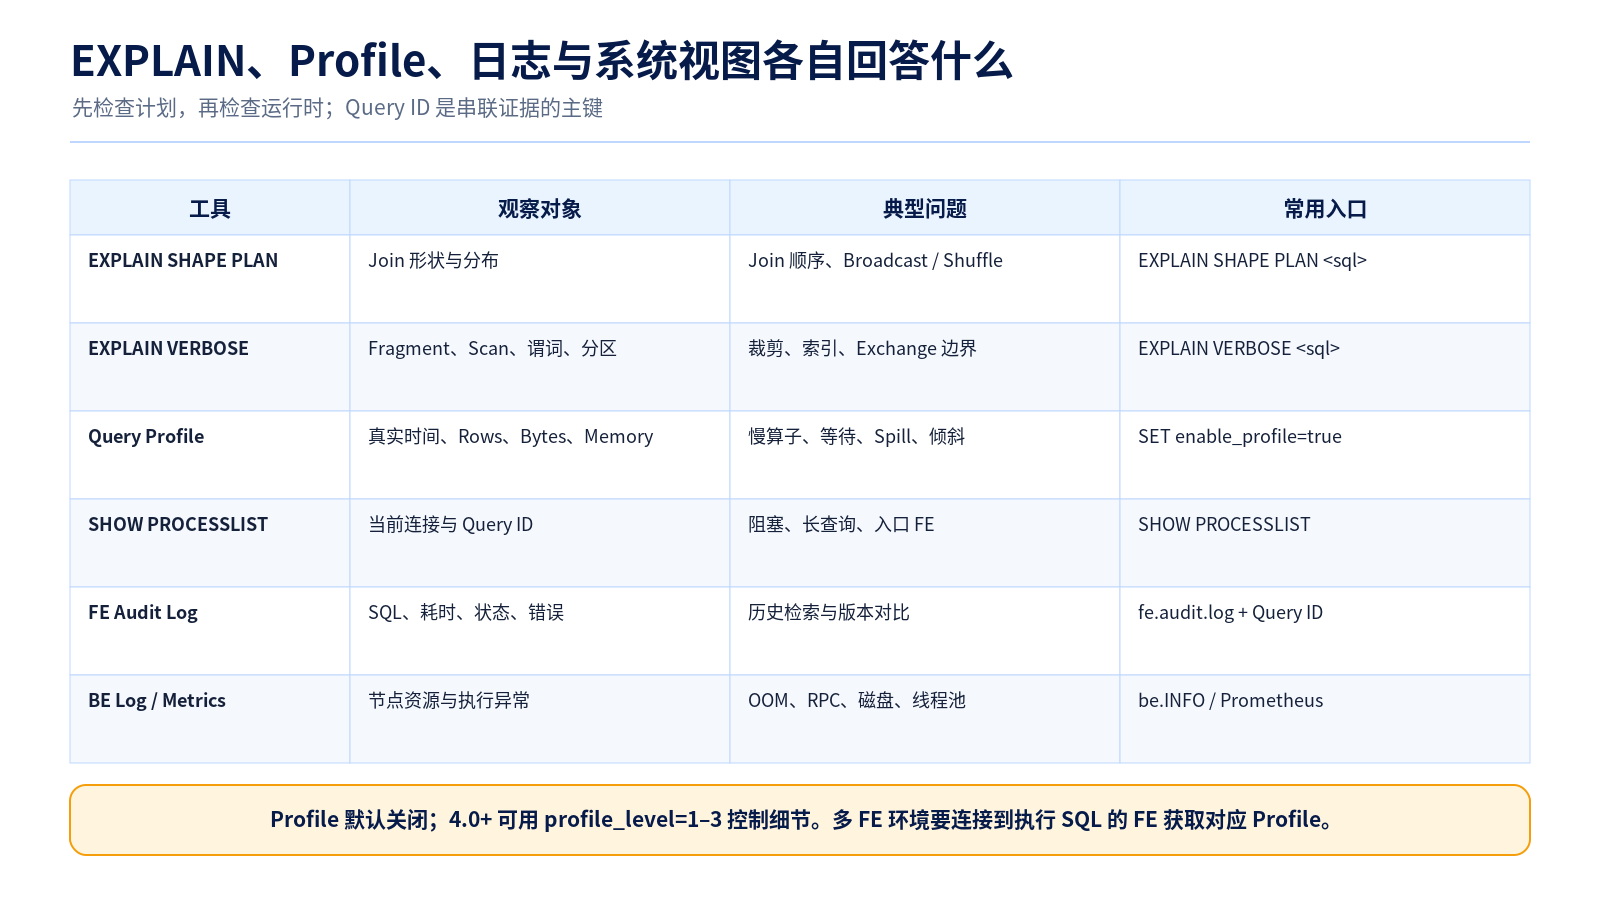
Explain 解决“计划是什么”,Profile 解决“执行时发生了什么”。当前官方 Query Profile 会记录算子耗时、输入输出行数、字节数、内存、等待、Spill 和多个 Instance 的聚合结果。
11.1 Profile 怎样收集
查询启动时,FE 的 ProfileManager 建立 Profile 结构。BE 执行结束后,通过异步上报线程池把各 Instance、Pipeline 和 Operator 的 Profile 发送给 FE。FE 将其聚合、保留并按策略持久化。
Profile 主要分为:
MergedProfile :跨 BE、Instance 和 PipelineTask 聚合后的视图,适合快速定位慢算子和数据倾斜;DetailProfile :每个 BE 上每条 PipelineTask 的细节,适合继续下钻。
11.2 开启方式
SET enable_profile = true;
SET profile_level = 2;
这里不写 GLOBAL,表示只在当前会话(连接)内生效,断开连接或新建连接后会恢复默认值。如果写成 SET GLOBAL enable_profile = true;,修改的是集群级默认值:它对已经建立的连接不生效,只影响之后新建的会话,并且需要管理员权限。日常排障通常使用会话级设置即可;只有希望长期调整集群默认行为时,才使用 GLOBAL。
当前官方口径中:
enable_profile 默认 false;profile_level 在 4.0+ 支持 1–3,默认 1;auto_profile_threshold_ms 可以只为超过阈值的慢查询生成 Profile;FE 会限制内存与磁盘上保留的 Profile 数量。
11.3 获取方式
SHOW QUERY PROFILE;
也可以通过执行 FE 的 Web UI 查看。多 FE 场景需要访问执行该 SQL 的 FE。若 SHOW QUERY PROFILE 为空,应依次检查:
enable_profile 是否开启;慢查询阈值是否过滤了本次 SQL;
当前连接的 FE 是否为原执行 FE;
Profile 异步上报是否超时;
FE 的 Profile 保留策略是否已经淘汰记录。
11.4 先看哪些指标
第一轮可以看:
ExecTime:算子耗时;InputRows / RowsProduced:数据如何放大或缩减;ScanRows / ScanBytes:扫描规模;PeakMemoryUsage:内存峰值;SpillBytes / SpillTime:落盘情况;BytesSent / BytesReceived:Exchange 网络量;WaitForDependency:依赖等待;min / avg / max:不同 Instance 是否倾斜。
EXPLAIN、Profile、日志与系统视图
官方调优指南建议先看 Explain,再看 Profile。这个顺序很重要:计划错误时,Profile 只能展示错误计划怎样消耗资源;计划合理时,Profile 才适合继续定位扫描、计算、网络、内存或等待瓶颈。
11.5 Profile 能看到执行事实,也有观察边界
Profile 的主体来自 BE 执行算子,并补充 FE 汇总信息。以下时间可能不会完整体现在某个 Operator 的 ExecTime 中:
客户端连接池等待;
负载均衡转发和网络握手;
大量外部元数据获取;
客户端参数绑定和结果渲染;
Profile 异步上报延迟;
查询结束后驱动继续拉取结果的时间。
因此,完整诊断需要四类时间戳:客户端请求开始/结束、FE Audit Log 开始/结束、Query Profile 总时间、应用侧结果消费完成时间。它们组合后可以区分数据库内部耗时和端到端耗时。
生产系统可以为规划阶段建立独立预算。例如在线查询要求 FE 规划 p95 小于 100 ms,复杂即席查询允许 500 ms,数据湖大规模 Split 规划允许更长时间。预算超标后再按 SQL 节点数、Join 数量、分区数、ScanRange 数和 MV 候选数分组分析,能够提前发现 FE 元数据和优化器压力。
Profile 全局开启会增加 FE 内存、磁盘和异步上报成本。更稳妥的策略是保留慢查询阈值,重点采集超过 SLA 的查询,并在专项压测会话中临时提高 profile_level。
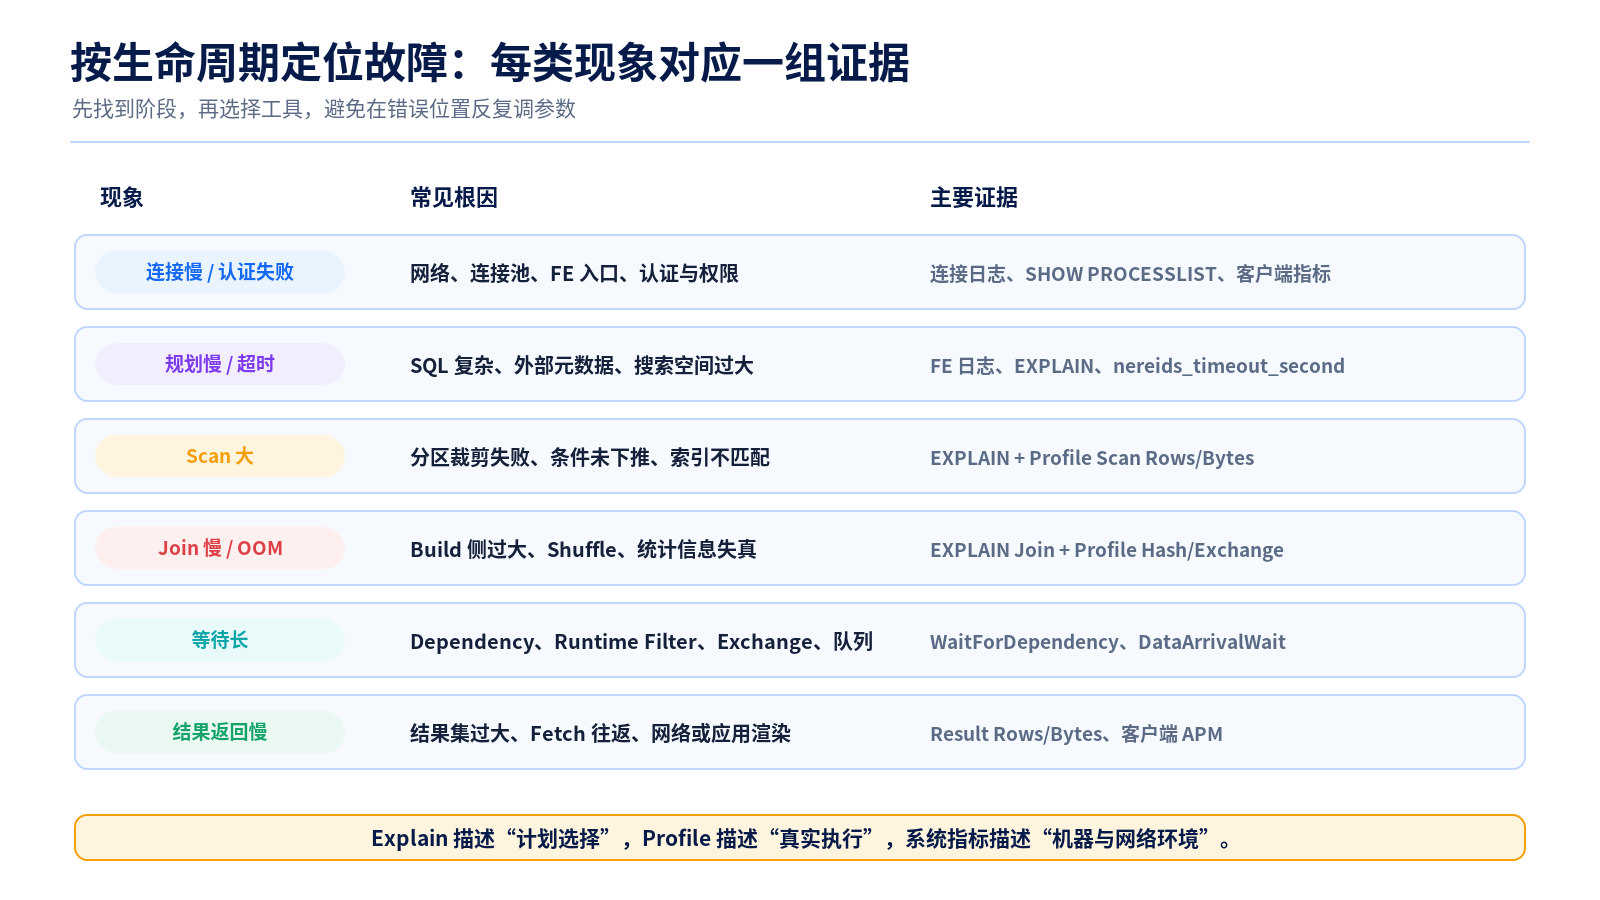
十二、规划阶段常见问题与证据链
生命周期瓶颈地图
12.1 SQL 文本过长和表达式规模过大
自动生成 SQL 可能包含数千个 OR、超大 IN 列表、多层 CASE、重复 CTE 和大量投影列。Parser、Binder 和优化器都要处理这些节点。治理方式包括参数表、临时表、Bitmap、人群包表和语义层模板,避免把大量业务集合直接展开成 SQL 文本。
12.2 多表 Join 导致搜索空间扩大
Join 表数量增加后,可选顺序和树形组合快速增加。Nereids 会利用规则和统计信息剪枝,但复杂报表仍可能形成较高规划成本。可以通过以下方式治理:
删除无效 Join;
把高频固定 Join 物化;
建立稳定宽表或公共汇总层;
保持统计信息新鲜;
将 Hint 作为验证后的例外配置,并定期复审。
12.3 物化视图候选过多
异步 MV 透明改写会增加候选搜索。单个业务域建立大量重叠 MV 时,规划阶段需要评估更多候选。MV 治理应包含命中率、刷新成本、重复度和下线机制。
12.4 外部元数据和 Split 爆炸
数据湖查询可能需要枚举数万个分区、文件或 Split。规划耗时、FE 内存和调度元数据都会上升。常见治理方式包括合并小文件、分区裁剪、限制 Split 数量、维护外部元数据缓存,并把文件规模纳入湖仓表的日常质量指标。
12.5 统计信息过期
数据量或分布显著变化后,CBO 的基数估算可能偏离真实情况。现象包括 Join 左右侧反转、Broadcast 过大、Shuffle 选择不合理、聚合行数估计失真。处理步骤:
ANALYZE TABLE target_table;
SHOW ANALYZE;
EXPLAIN SHAPE PLAN SELECT ...;
EXPLAIN VERBOSE SELECT ...;
保存更新前后的 Explain,才能证明计划发生了什么变化。
12.6 分区、Tablet 和 ScanRange 过多
细粒度分区、Bucket 数量过高和大量小文件会提高 FE 生成 ScanRange 与 BE 调度的成本。表结构评审不能只关注单个 Tablet 大小,还要关注整张表、整个 Catalog 和单次查询涉及的元数据规模。
12.7 返回结果过大
用户常把“查询慢”归因于数据库计算,实际时间可能消耗在结果传输。Profile 中若 Scan、Join 和聚合耗时较低,ReturnRows 极大,优化重点应转向:
限制返回列;
聚合后再返回;
使用 TopN 和分页;
导出任务使用专用链路;
调整客户端 Fetch Size;
避免 BI 工具把超大明细结果直接渲染到浏览器。
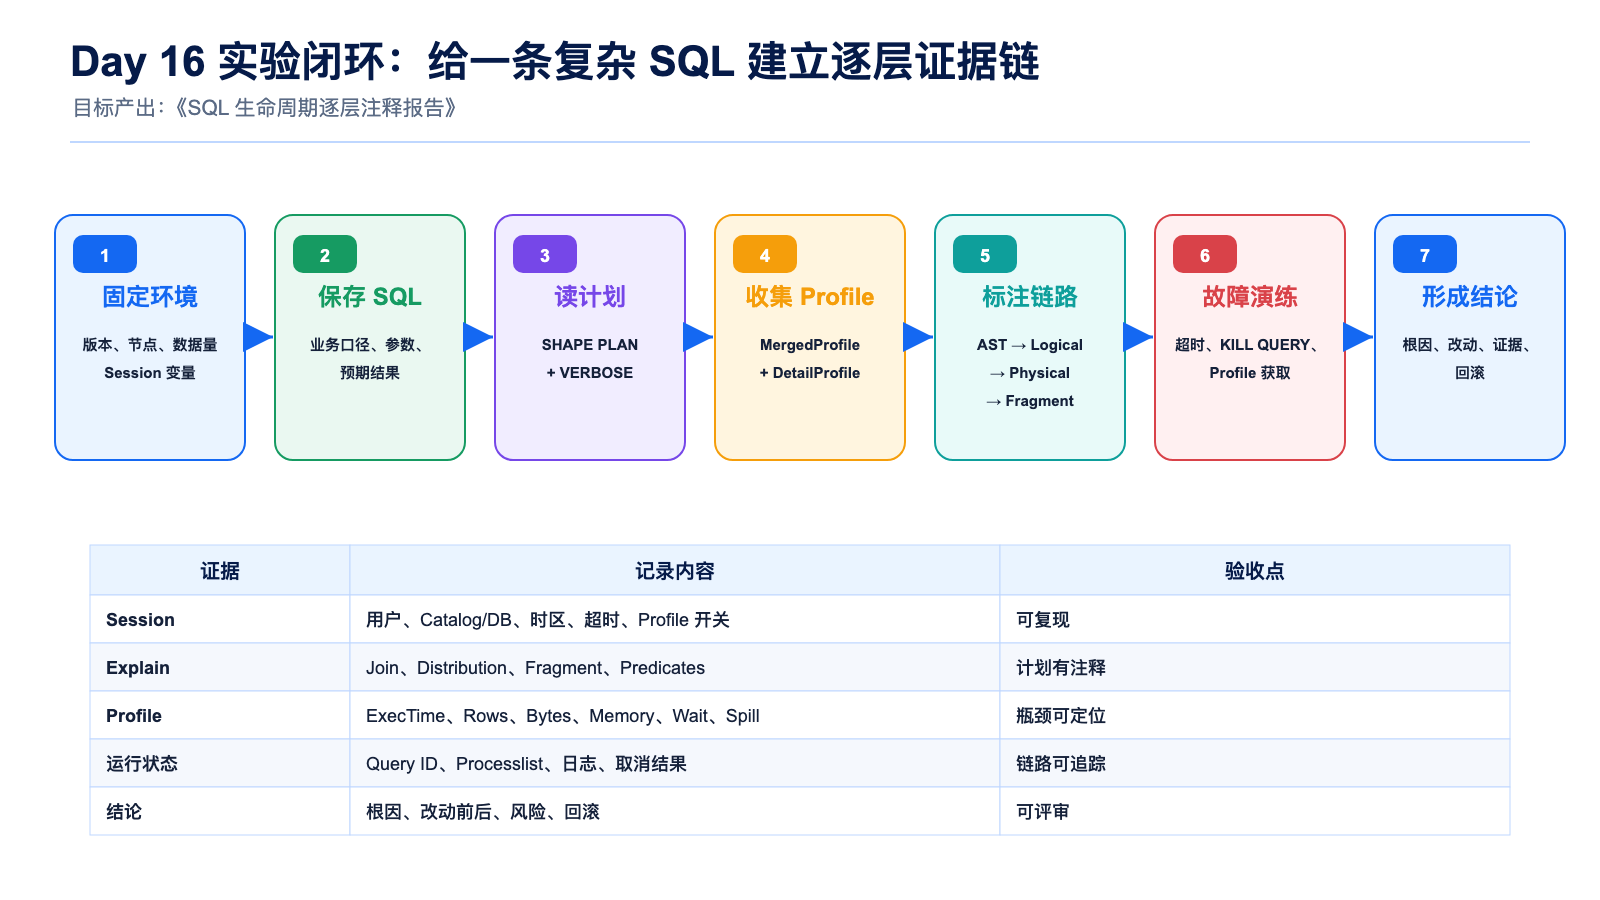
十三、实战:为一条复杂 SQL 建立逐层注释报告
完整包提供三张表:区域维表、用户维表和订单事实表。实验 SQL 会执行两次 Join、聚合、排序和 Limit,足以生成多个逻辑节点和 Fragment。
实验闭环
第一步:固定环境
记录:
Doris 版本和部署模式;
FE / BE 节点;
表行数、分区和 Bucket;
当前用户、Catalog、Database;
Session Variables;
是否经过负载均衡;
数据导入完成时间。
第二步:保存原始 SQL 和参数
业务参数必须展开为实际值。只保存带问号的 PreparedStatement 模板无法复现选择性、分区范围和基数估算。
第三步:保存两类 Explain
EXPLAIN SHAPE PLAN <sql>;
EXPLAIN VERBOSE <sql>;
逐层标注:
Scan 哪些表;
谓词下推到哪里;
裁剪了多少分区;
Join 顺序和分布;
本地/全局聚合;
Exchange 边界;
Root Fragment;
估算基数。
第四步:开启 Profile 并执行
SET enable_profile = true;
SET profile_level = 2;
执行查询后保存 Query ID、Profile ID、MergedProfile 和必要的 DetailProfile。
第五步:对照估算与实际
重点比较:
对象
Explain 估算
Profile 实际
Scan 行数
cardinality
ScanRows
Join Build
估算输入
BuildRows / HashTable Memory
Join Probe
估算输入
ProbeRows
聚合输出
估算分组数
RowsProduced
网络
Distribution
BytesSent / Received
并行度
Instance 规划
Instance min/avg/max
估算和实际差距很大时,优先检查统计信息、数据倾斜和过滤选择性。
第六步:执行取消演练
在测试环境运行一条可控长查询,通过另一个会话执行:
SHOW PROCESSLIST;
KILL QUERY <processlist_id>;
确认查询状态变化、客户端错误、BE 任务停止、内存释放和审计记录。取消能力属于生产稳定性的基础能力,不能等到事故时第一次验证。
第七步:形成报告
《SQL 生命周期逐层注释报告》至少应包含:
环境与版本;
SQL、参数和业务口径;
Session 快照;
AST/绑定逻辑说明;
Explain Shape 与 Verbose;
Fragment DAG;
Instance 分布;
Profile 关键指标;
估算与实际差异;
根因、修改、验证和回滚方案。
一个完整案例:月度经营报表突然从 2 秒升到 18 秒
假设某条城市与品类经营报表长期稳定在 2 秒,历史回灌后上升到 18 秒。按照生命周期诊断,可以这样推进:
连接与 Session。 确认业务账号、Catalog、Database、时区、Workload Group 和入口 FE均未变化;客户端连接等待只有几十毫秒。Explain 对比。 旧计划对 dim_user 使用 Broadcast,新计划把事实表一侧作为 Hash Build,并产生两侧 Shuffle;估算行数显示事实表过滤后只有 20 万行。Profile 对比。 实际过滤后仍有 3200 万行,Hash Table 峰值达到数 GB,Exchange 网络量显著上升。估算与实际差距超过两个数量级。统计信息。 历史回灌后未及时更新统计信息,row_count 和日期选择性仍停留在旧值。修复。 执行 ANALYZE TABLE fact_order,等待任务完成,再次生成 Explain。Join 左右侧和 Distribution 恢复合理选择。验证。 冷缓存和目标并发下运行十轮,p95 回落到 2.3 秒;Profile 中 Hash Table、Shuffle Bytes 和 PeakMemory 同步下降。固化。 将大批量回灌完成后的统计信息刷新加入数据任务;告警同时监控规划估算与 Profile 实际行数差距。
这个案例说明,SQL 文本、数据量和硬件都没有立即给出答案。Session、Explain、Profile、统计信息和改动前后证据共同构成根因链路。
十四、Knowledge Check
1. AST 与 Bound Logical Plan 的主要差异是什么?
AST 主要表达 SQL 语法结构;Bound Logical Plan 已经完成表、列、函数、类型和权限等绑定,能够明确表达业务语义。
2. 语法正确的 SQL 为什么仍会失败?
表或列可能不存在,列名可能歧义,类型可能不兼容,聚合规则可能不合法,用户也可能缺少权限。这些问题在绑定和语义分析阶段暴露。
3. RBO 主要处理什么?
它用确定性规则改写计划,例如常量折叠、谓词下推、列裁剪、分区裁剪、Limit 下推和子查询改写。
4. CBO 为什么需要统计信息?
统计信息帮助估算行数、选择性、数据大小和分布,从而比较 Join 顺序、算法、Distribution 和聚合方式的成本。
5. PlanNode、PlanFragment 和 Fragment Instance 各自是什么?
PlanNode 是计划中的算子节点;PlanFragment 是 FE 可下发的分布式工作单元;Fragment Instance 是某个 Fragment 在具体 BE 上的运行副本。
6. Exchange 为什么会切断 Fragment?
Exchange 改变数据分布并通过网络连接上下游,发送和接收两侧需要独立调度,因此形成 Fragment 边界。
7. Coordinator 在哪里运行?
Coordinator 位于 FE 侧,负责 Fragment DAG、节点选择、任务下发、状态收集、取消传播和结果汇聚。
8. Explain 与 Profile 的分工是什么?
Explain 展示计划和估算;Profile 展示运行时真实耗时、行数、字节、内存、等待、Spill 和实例差异。
9. 为什么在多 FE 环境中可能查不到 Profile?
Profile 保存在执行该 SQL 的 FE,当前连接如果落到其他 FE,可能看不到对应记录。
10. 规划耗时高时,第一轮应该检查哪些内容?
检查 SQL 节点规模、Join 表数量、视图/CTE 层级、物化视图候选、统计信息、外部分区/文件/Split 数量、FE CPU 和元数据规模。
十五、本日总结
一条 SQL 从客户端到结果返回,会经历以下稳定层次:
Client / Driver
→ FE Session
→ Parser / AST
→ Binder & Analyzer
→ Bound Logical Plan
→ RBO / CBO / Memo
→ Physical Plan
→ PlanFragment DAG
→ Fragment Instances
→ BE PipelineTasks
→ Root Fragment / Result Sink
→ Protocol Return
理解这条链路后,慢查询诊断会从“尝试几个参数”升级为一套证据驱动的方法:先确认用户感知耗时落在哪只时钟,再保存 Session、Explain、Profile、Query ID 和日志;随后区分计划问题、执行问题、调度问题与返回问题;每次修改都保留改动前后的对照和回滚方案。
明天进入 Day 7:SQL、数据类型与函数体系 。我们会从 MySQL 协议兼容、类型语义、精度、时间、复杂类型和函数分类出发,建立一套能够支撑正确建模的 SQL 基础。
官方资料与版本依据
版本提示:截至 2026-08-17,官方下载页标记 4.1.3 为 Latest、4.0.8 为 Stable。Nereids 是 4.x 查询规划主路径。具体 Operator 名称、Profile Counter、规则和代价模型可能随版本演进,生产实验应以目标版本实际 Explain 与 Profile 为准。